

في 18 نوفمبر 2025، واجهت Cloudflare انقطاعًا عالميًا كبيرًا أثر على حركة المرور حول العالم. قرابة الساعة 11:20 UTC، بدأت أنظمة Cloudflare تعجز عن إيصال حركة الشبكة الأساسية بعدما تسبب تغيير داخلي في الصلاحيات في تضاعف حجم أحد «ملفات الميزات» في Bot Management على نحو غير متوقع. تجاوز الملف المتضخم حدود السعة على أجهزة الحافة، مما أدى إلى أعطال في برمجيات التوجيه في أجزاء واسعة من شبكة Cloudflare العالمية.
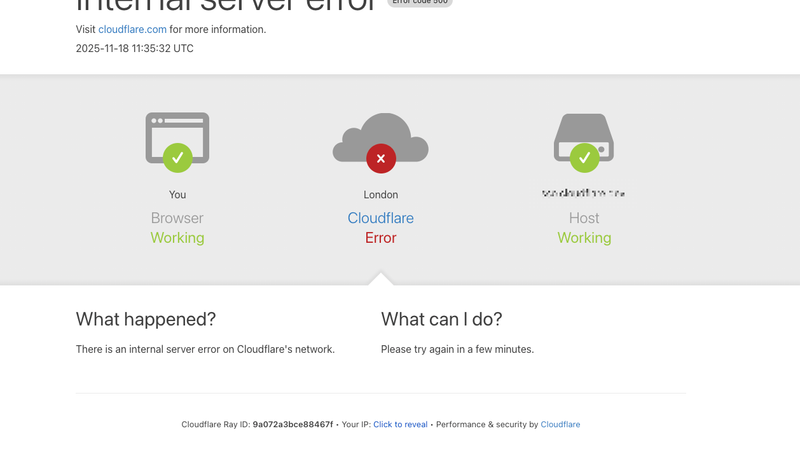
كما توضح Cloudflare في المقال الرسمي في المدونة، لم تكن هذه الحادثة هجومًا ولا نتيجة نشاط خبيث، بل نتجت عن تغيير تشغيلي امتد أثره إلى الخدمات الأساسية لمعالجة حركة المرور. وتأثرت بشدة لوحة التحكم وتقييم الروبوتات وبعض وظائف الحافة، بينما ظلت واجهة API أكثر استقرارًا طوال الحادثة. بدأت Cloudflare طرح إصلاح قرابة الساعة 14:30 UTC، واستعادت حركة المرور الطبيعية بالكامل بحلول الساعة 17:06 UTC.
ما الذي رصدناه
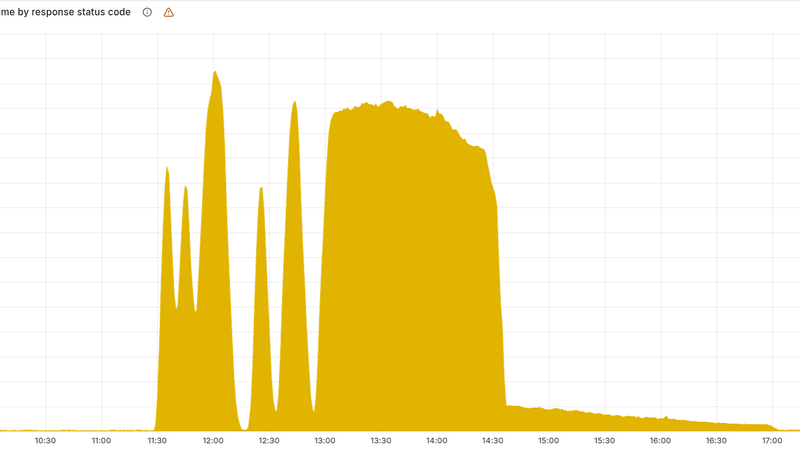
رصدت أنظمة المراقبة لدينا سلوكًا غير معتاد قبل الإعلان العام. وفي نحو الساعة 11:35 UTC، بدأنا نرصد ارتفاعًا واسعًا في الأخطاء، وزيادة في زمن الاستجابة بين نقاط حافة Cloudflare وخوادم المصدر لدى العملاء، وسلوكًا غير متسق في خدمات Bot Management وWAF. ولأن الأعراض ظهرت في بيئات مستقلة لعدة عملاء، تأكد فريقنا سريعًا من أن المشكلة ليست في خوادم المصدر، بل لدى مزوّد الخدمة.
رغم أننا رصدنا المشكلة قبل إشعار Cloudflare العام عند الساعة 11:48 UTC، فإننا نود أن نعتذر بصدق. كان اكتشافنا مبكرًا، لكن إرسال التنبيهات واستجابات دعم العملاء كان يمكن أن يكونا أسرع. كان ينبغي أن نتحرك بسرعة أكبر لإبلاغ العملاء وبدء التخفيف المنسّق، ونتخذ خطوات ملموسة لتحسين ذلك مستقبلًا.
كيف ساعدنا العملاء على البقاء متصلين
بمجرد أن تأكدنا من تدهور شبكة Cloudflare العالمية، بدأ فريقنا العمل مع العملاء المتأثرين لتقليل مدة التوقف. ولأن واجهة API لدى Cloudflare ظلت متاحة خلال معظم الحادثة بينما كانت لوحة التحكم تتعطل، تمكنا من إجراء تغييرات طارئة لعدد من عملاء Enterprise وManaged Cloudflare.
لدى العملاء الذين لم يعتمدوا على Cloudflare Origin Certificates، أجرينا مؤقتًا ما يلي: عطّلنا وكيل Cloudflare ووجّهنا حركة مرورهم مباشرة إلى خوادم المصدر لديهم. أتاح لهم ذلك تجاوز الأجزاء المتأثرة من شبكة حافة Cloudflare بالكامل مع الإبقاء على تحليل أسماء DNS. ولدى كثير من العملاء، أعاد هذا الإجراء الاستقرار إلى أن أكملت Cloudflare الإصلاح وعادت حركة المرور إلى وضعها الطبيعي.
عندما أعلنت Cloudflare عودة شبكتها إلى العمل السليم، أعدنا تفعيل الوكيل، وتحققنا من سلوك SSL، وأكدنا أداء التوجيه عبر جميع النطاقات المتأثرة.
التحسينات التي نجريها
أبرز هذا الانقطاع أهمية القدرة على الاستجابة الفورية عندما يواجه مزوّد نعتمد عليه حادثة جسيمة. ومع نجاح إجراءات التخفيف إجمالًا، نؤمن بأن بإمكاننا، وبأن علينا، تقديم أداء أفضل.
إليك كيف نعمل على التحسين:
«مفتاح إيقاف طارئ» بنقرة واحدة في Vigilbase One
نضيف أداة تحكم عامة داخل Vigilbase One لتعطيل وكيل Cloudflare بالكامل لأي نطاق أو ملف عميل محدد. سيحوّل ذلك الخدمات فورًا إلى وضع DNS فقط، ويوجّه حركة المرور مباشرة إلى خادم المصدر من دون تدخل يدوي. وهذا يعني قدرتنا على استعادة الاتصال خلال ثوانٍ بدلًا من دقائق.
نسخ احتياطية كاملة للبنية التحتية باستخدام Terraform
مع أن كثيرًا من عمليات النشر لدينا كانت تستخدم Terraform داخليًا، فإن توسيع استخدامه ليشمل جميع العملاء يتيح لنا إجراء تغييرات شاملة بسرعة. ونحن نطبّق نسخًا احتياطية كاملة للإعدادات، تشمل:
- ملفات مناطق DNS الكاملة (بتنسيق BIND)
- حزم إعدادات Cloudflare الكاملة
- حالة Terraform وموارده الخاضعة للتحكم في الإصدارات
إذا واجهت Cloudflare مجددًا عطلًا واسعًا في مستوى التحكم، فسنتمكن من تعديل الإعدادات واستعادتها بسرعة أكبر بكثير.
تعزيز المراقبة الفورية باستخدام Flarehawk
ندمج Flarehawk، محرك تحليل حركة المرور المدعوم بالذكاء الاصطناعي لدينا، للكشف الآلي عن حالات غير معتادة، مثل عدم استقرار التوجيه لدى المزوّدين والارتفاع المفاجئ في الأخطاء أو زمن الاستجابة. وسترتبط هذه الإشارات بمحفزات الأتمتة، ومنها مفتاح الإيقاف الطارئ الجديد.
تنبيهات أسرع وأكثر وضوحًا للعملاء
نحدّث أدلة الاستجابة للحوادث وبروتوكولات التواصل، ليتلقى العملاء إشعارًا فوريًا عند رصد مشكلات لدى المزوّدين الذين نعتمد عليهم. يجب أن يؤدي الاكتشاف المبكر إلى تحرك مبكر، ونحن نعيد تصميم عملياتنا لضمان ذلك.
أفكار ختامية
كان انقطاع Cloudflare في 18 نوفمبر من أكثر الأحداث تعطيلًا في الذاكرة القريبة، وندرك أثره على مؤسسات كثيرة حول العالم. وندرك أيضًا أنه رغم اكتشاف Vigilbase المبكر للمشكلة، كان يمكن أن تكون استجابتنا أسرع، ونعتذر عن ذلك.
للأسف، ليست Cloudflare محصنة ضد هذا النوع من الحوادث، شأنها شأن أي شركة تقنية أخرى. ومثلما حدث مؤخرًا في Microsoft Azure وAmazon Web Services من الحوادث، يبيّن ذلك هشاشة الإنترنت عالميًا وحاجتنا، بصفتنا مزوّد خدمات مُدارة، إلى التحرك سريعًا فور رصد أنظمتنا مشكلات لدى مزوّدي الخدمات الذين نعتمد عليهم.
نلتزم بالتعلم من هذه الحادثة وتعزيز كل طبقة من قدرات المراقبة والأتمتة والاستجابة لدينا. ومع التحسينات الجاري تنفيذها، سنكون أفضل استعدادًا لحماية عملائنا من أي اضطرابات مستقبلية لدى المزوّدين الذين نعتمد عليهم.
إذا كانت لديكم أسئلة بشأن الانقطاع أو كيفية منع تأثير الانقطاعات والحوادث المستقبلية على بنيتكم التحتية، فتواصلوا مع فريق الدعم أو فريق حسابكم.
يمكنك قراءة المزيد عن الانقطاع في مدونة Cloudflare.
شملت خدماتنا المتأثرة ما يلي:
- Cloudflare Enterprise
- Vigilbase Managed Cloudflare
- Vigilbase Shield
- Vigilbase One، لوحة تحكم العملاء
- Flarehawk، لوحة تحكم العملاء
تقارير الحالة للحوادث:
