

A 18 de novembro de 2025, a Cloudflare sofreu uma falha global significativa que afetou o tráfego em todo o mundo. Por volta das 11:20 UTC, os sistemas da Cloudflare começaram a falhar na entrega do tráfego essencial de rede depois de uma alteração interna de permissões ter feito com que um dos seus “ficheiros de funcionalidades” do Bot Management duplicasse inesperadamente de tamanho. Este ficheiro sobredimensionado excedeu os limites de capacidade das máquinas de edge, o que, por sua vez, despoletou falhas no software de encaminhamento em grandes partes da rede global da Cloudflare.
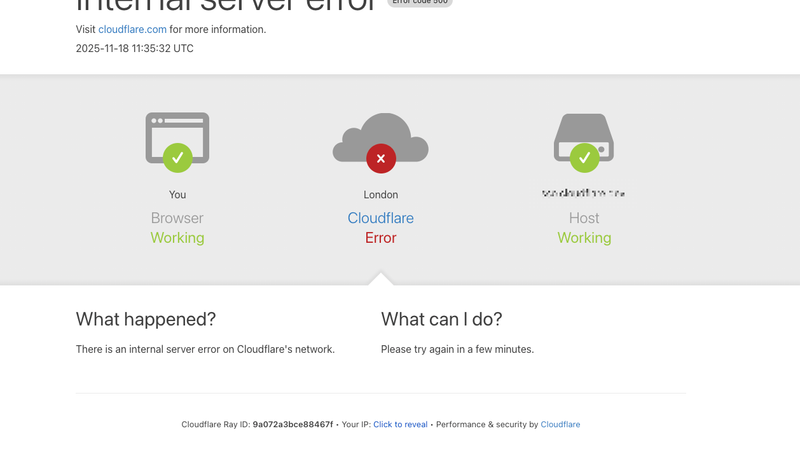
Como a Cloudflare explica no seu artigo oficial no blog, este incidente não foi um ataque, nem foi causado por atividade maliciosa; foi antes o resultado de uma alteração operacional que se propagou em cascata para os serviços essenciais de processamento de tráfego. O seu painel de controlo, a pontuação de bots e determinadas funções baseadas em edge foram fortemente afetados, enquanto a sua API permaneceu muito mais estável ao longo do incidente. A Cloudflare começou a implementar uma correção por volta das 14:30 UTC e restaurou totalmente o fluxo normal de tráfego às 17:06 UTC.
O Que Observámos
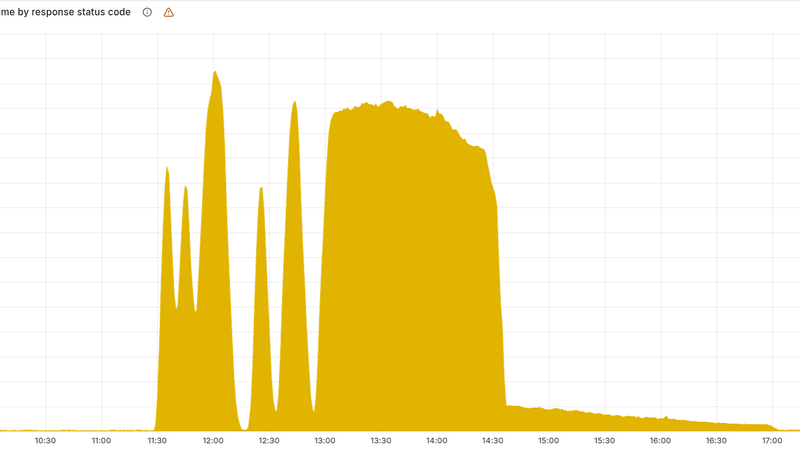
Os nossos sistemas de monitorização detetaram um comportamento invulgar antes do anúncio público. Por volta das 11:35 UTC, começámos a observar picos de erro generalizados, latência elevada entre os edges da Cloudflare e os servidores de origem dos clientes, e um comportamento inconsistente nos serviços de Bot Management e WAF. Como os sintomas eram comuns a muitos ambientes independentes de clientes, a nossa equipa confirmou rapidamente que não se tratava de um problema de origem, mas sim de um problema a montante.
Embora tenhamos identificado o problema antes do aviso público da Cloudflare às 11:48 UTC, queremos pedir sinceras desculpas. A nossa deteção foi precoce, mas as nossas respostas de alerta e de apoio ao cliente poderiam ter sido mais rápidas. Devíamos ter agido mais depressa para notificar os clientes e iniciar uma mitigação coordenada, e estamos a tomar medidas concretas para garantir que isto melhora no futuro.
Como Ajudámos os Clientes a Manterem-se Online
Assim que confirmámos que a rede global da Cloudflare se estava a degradar, a nossa equipa começou a trabalhar com os clientes afetados para reduzir o tempo de indisponibilidade. Como a API da Cloudflare permaneceu acessível durante a maior parte do incidente (enquanto o próprio painel de controlo falhava), conseguimos efetuar alterações de emergência para vários dos nossos clientes Enterprise e de Cloudflare Geridas.
Nos casos em que os clientes não dependiam dos Cloudflare Origin Certificates, desativámos temporariamente o proxy da Cloudflare e encaminhámos o seu tráfego diretamente para os seus servidores de origem. Isto permitiu-lhes contornar por completo as partes afetadas da rede de edge da Cloudflare, mantendo ao mesmo tempo a resolução de DNS ativa. Para muitos clientes, esta ação restaurou a estabilidade até a Cloudflare concluir a sua correção e o tráfego normalizar.
Quando a Cloudflare comunicou que a sua rede tinha regressado a um funcionamento saudável, reativámos o proxy, validámos o comportamento do SSL e confirmámos o desempenho do encaminhamento em todos os domínios afetados.
Melhorias Que Estamos a Implementar
Esta falha realçou a importância de conseguir reagir instantaneamente quando um fornecedor a montante sofre um evento catastrófico. Embora a nossa mitigação global tenha funcionado, acreditamos que podemos, e devemos, fazer melhor.
Eis como estamos a melhorar:
Um “Interruptor de Emergência” de Um Clique no Vigilbase One
Estamos a adicionar um controlo global dentro do Vigilbase One que desativa totalmente o proxy da Cloudflare para qualquer domínio ou perfil de cliente selecionado. Isto irá comutar instantaneamente os serviços para o modo apenas DNS e encaminhar o tráfego diretamente para a origem, sem intervenção manual. Significa que conseguimos restaurar a conectividade em segundos, e não em minutos.
Cópias de segurança completas da infraestrutura com Terraform
Embora muitas das nossas implementações já utilizassem o Terraform internamente, ao expandir a nossa utilização do Terraform a todos os clientes, conseguimos fazer alterações de forma rápida e abrangente. Estamos a implementar cópias de segurança completas da configuração, incluindo:
- Ficheiros completos das zonas DNS (formato BIND)
- Pacotes completos de configuração da Cloudflare
- Estado e recursos do Terraform com controlo de versões
Se a Cloudflare voltar a sofrer uma falha de grande escala no plano de controlo, conseguiremos modificar e restaurar as configurações de forma muito mais rápida.
Monitorização em Tempo Real Reforçada com o Flarehawk
Estamos a integrar o Flarehawk, o nosso motor de análise de tráfego orientado por IA, para detetar automaticamente anomalias como instabilidade no encaminhamento a montante, picos de erro súbitos ou aumentos acentuados de latência. Estes sinais serão ligados a acionadores de automação, incluindo o novo interruptor de emergência.
Alertas a Clientes Mais Rápidos e Transparentes
Estamos a atualizar os nossos manuais de resposta a incidentes e os protocolos de comunicação para que os clientes recebam notificação imediata quando detetarmos problemas a montante. A deteção precoce tem de conduzir a uma ação precoce, e estamos a redesenhar os nossos processos para o garantir.
Reflexões finais
A falha da Cloudflare a 18 de novembro foi um dos eventos mais disruptivos da memória recente, e reconhecemos o impacto que causou em muitas organizações em todo o mundo. Reconhecemos também que, embora a Vigilbase tenha detetado o problema precocemente, a nossa resposta poderia ter sido ainda mais rápida e, por isso, pedimos desculpa.
A Cloudflare, tal como qualquer outra empresa de tecnologia, infelizmente não está imune a este tipo de incidentes. Tal como os recentes incidentes da Microsoft Azure e Amazon Web Services, isto demonstra a fragilidade da internet mundial e a nossa necessidade, enquanto fornecedor de serviços geridos, de agir rapidamente assim que os nossos sistemas detetam problemas em fornecedores a montante.
Estamos empenhados em aprender com este incidente e em reforçar todas as camadas das nossas capacidades de monitorização, automação e resposta. Com as melhorias agora em curso, estaremos mais bem preparados para proteger os nossos clientes contra quaisquer futuras disrupções a montante.
Se tiver alguma questão relativa à falha, ou sobre como iremos evitar que futuras falhas e incidentes afetem a sua infraestrutura, contacte a nossa equipa de apoio ou a sua equipa de conta.
Pode ler mais sobre a falha no The Cloudflare Blog.
Os nossos serviços afetados incluíram:
- Cloudflare Enterprise
- Vigilbase Cloudflare gerido
- Vigilbase Shield
- Vigilbase One (painel de controlo do cliente)
- Flarehawk (painel de controlo do cliente)
Relatórios de incidentes de estado:
